Blog & Ressources

Nos derniers Insights

Découvrez nos analyses, guides et actualités sur l'intelligence artificielle et l'automatisation.

🧠 ReAct : le pattern fondateur des agents IA autonomes
Article
16 Jun 2026 • Lecture 5 min

🧠 ReAct : le pattern fondateur des agents IA autonomes

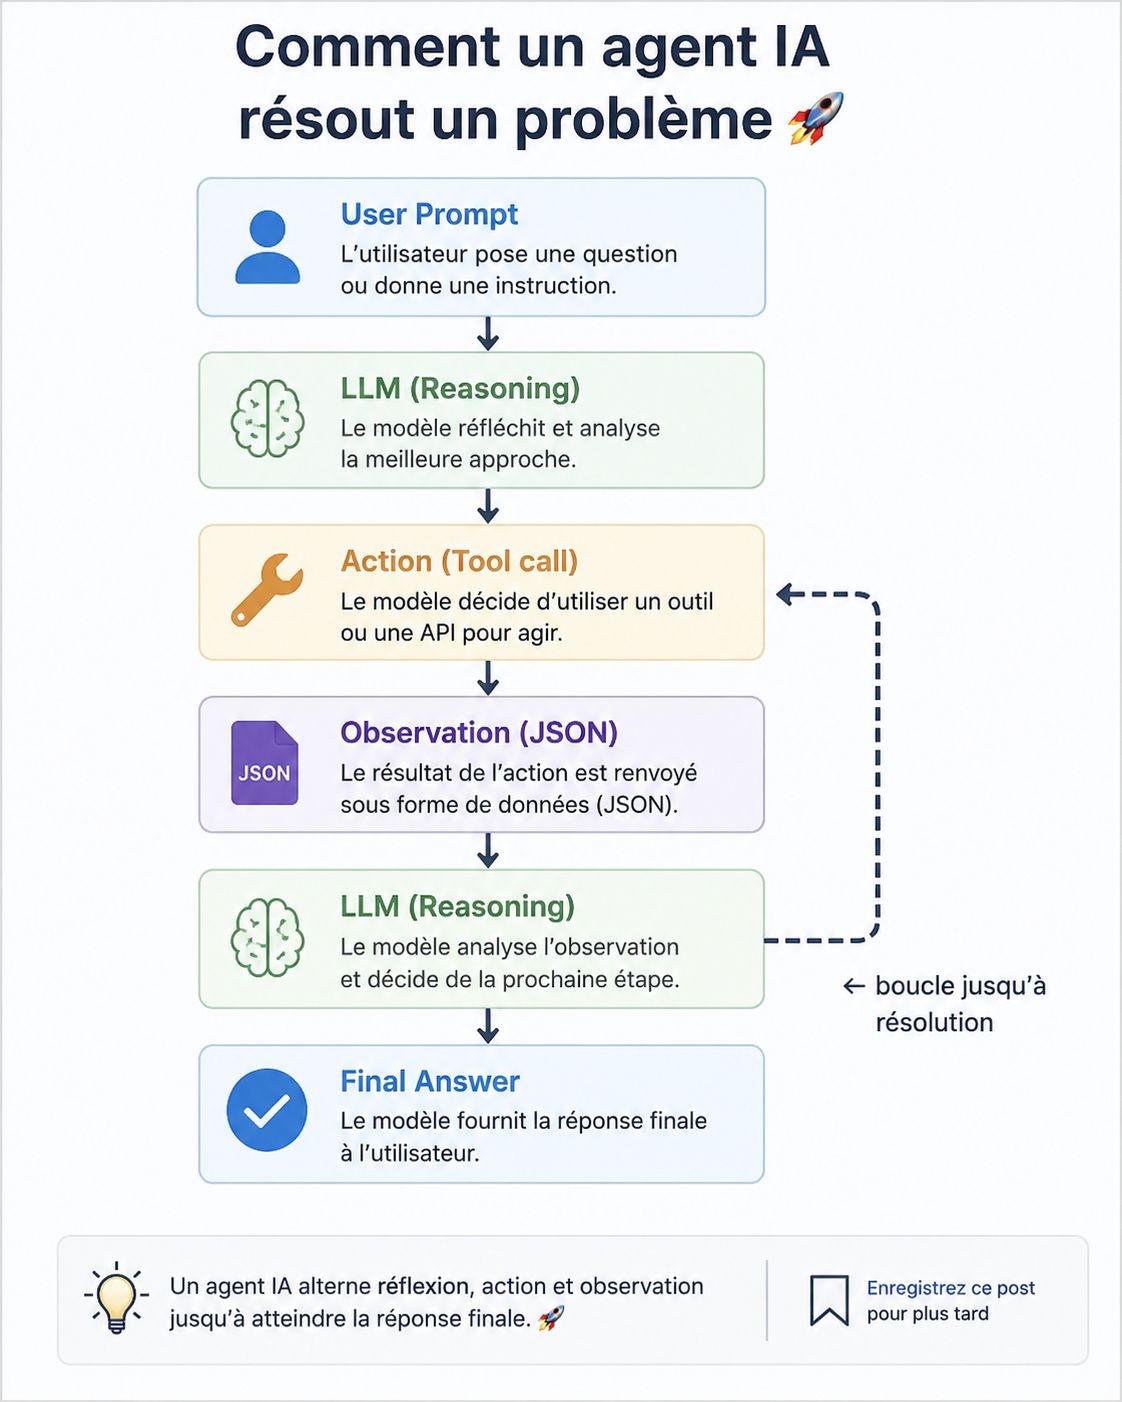
Avant les agents IA tels qu'on les connaît aujourd'hui, un paper a tout changé. En octobre 2022, Shunyu Yao, Jeffrey Zhao, Dian Yu et leurs collègues de Google & Princeton publient : "ReAct: Synergizing Reasoning and Acting in Language Models" 📄 arXiv:2210.03629 Publié quelques semaines avant ChatGPT, ce travail pose les bases de ce que nous appelons aujourd'hui les agents IA autonomes. 💡 L'idée centrale Avant ReAct, un LLM faisait deux choses séparément : Raisonner (Chain-of-Thought) Agir (exécuter des actions) ReAct fusionne les deux en un cycle entrelacé et continu : le modèle raisonne, agit, observe, puis raisonne à nouveau jusqu'à la réponse finale. ⚙️ Comment fonctionne le pattern ? 1️⃣ Input utilisateur Le prompt arrive accompagné de la liste des outils disponibles (API, base de données, moteur de recherche…) 2️⃣ Reasoning 🧠 Le LLM analyse le contexte et détermine quel outil utiliser et avec quels paramètres. Il ne répond pas encore, il réfléchit. 3️⃣ Action ⚡ L'agent appelle l'outil sélectionné pour interagir avec l'environnement extérieur. 4️⃣ Observation 👁️ Le résultat de l'outil (retourné en JSON) est renvoyé au LLM comme nouvelle information. 5️⃣ Nouveau cycle de Reasoning Le LLM analyse l'observation et décide : l'information est-elle suffisante ? Si non → nouvelle action. Si oui → on passe à l'étape suivante. ➡️ La boucle continue jusqu'à ce que le contexte nécessaire soit complet. 6️⃣ Final Answer ✅ Le LLM synthétise toutes les observations et fournit la réponse finale.
⚠️ Déployer un agent IA en production, c'est bien plus complexe qu'un simple POC.
Article
23 Jun 2026 • Lecture 5 min

⚠️ Déployer un agent IA en production, c'est bien plus complexe qu'un simple POC.

Voici les défis techniques que personne ne mentionne vraiment : 🔁 1. LA BOUCLE INFINIE (Infinite Loop) Un agent peut tourner indéfiniment s'il ne converge pas vers un résultat. Sans mécanisme de timeout ou de max_iterations, votre infra brûle des tokens et de l'argent en silence. ✅ Solution : circuit breaker + budget de tokens fixe par run. 🧠 2. LA GESTION DE LA MÉMOIRE La mémoire contextuelle est limitée par la taille du context window. Au-delà ? L'agent oublie. Il hallucine. Il se contredit. ✅ Solution : combiner short-term memory (in-context) + long-term memory via vector DB (Pinecone, pgvector). 💸 3. LE COÛT DES TOKENS Un agent multi-étapes peut consommer 10x plus de tokens qu'un simple chatbot. En production, sur des milliers d'utilisateurs, la facture explose vite. La clé : choisir le bon modèle selon le besoin réel. → Gemini Flash pour traiter de gros volumes de documents → Claude Opus 4 pour les tâches à fort raisonnement → Modèles légers pour les appels répétitifs et simples ✅ Solution : prompt compression + caching sémantique (GPTCache) + routing intelligent selon la complexité de la tâche. 🔐 4. LA SÉCURITÉ : PROMPT INJECTION Un agent qui navigue sur le web ou lit des fichiers externes peut être manipulé par du contenu malveillant injecté dans les données. ✅ Solution : sandboxing strict + validation des inputs/outputs + principe du moindre privilège sur chaque outil. ⏱️ 5. LA LATENCE Chaque appel LLM prend du temps. Un agent multi-étapes peut prendre 30 à 60 secondes et en UX, c'est inacceptable. ✅ Solution : parallélisation des sous-tâches + streaming des réponses + architecture asynchrone. La vérité ? Construire un agent IA, c'est 20% du travail. Le tenir en production de façon fiable, c'est les 80% restants. Vous avez rencontré d'autres défis en prod ? Partagez en commentaire 👇

Pourquoi transformer les données en vecteurs dans un système RAG ?
Article
30 Jun 2026 • Lecture 5 min

Pourquoi transformer les données en vecteurs dans un système RAG ?

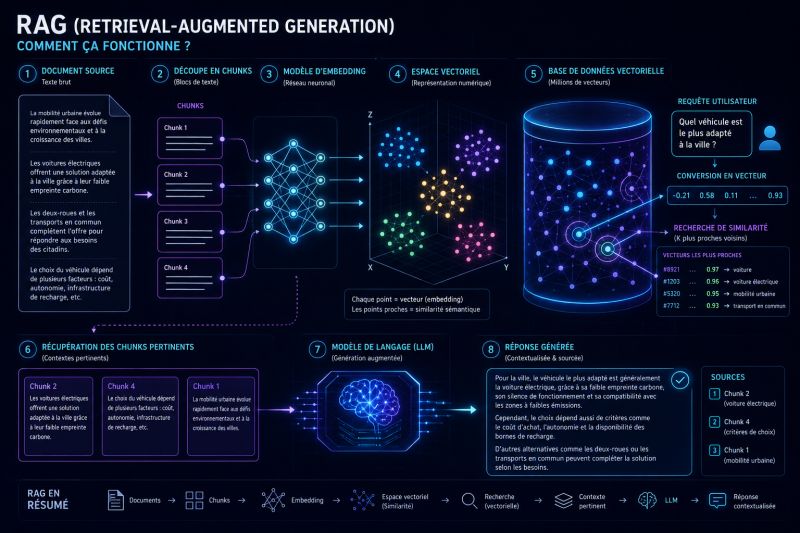
Dans une architecture RAG (Retrieval-Augmented Generation), les données sont généralement stockées dans une base vectorielle plutôt que dans une base de données traditionnelle. 1. Une recherche basée sur le sens Une base de données classique recherche principalement des correspondances exactes de mots-clés. Ainsi, une requête contenant le mot « véhicule » pourrait ne pas retrouver un document contenant uniquement le mot « voiture ». À l'inverse, une base vectorielle représente les textes sous forme de vecteurs numériques. Les contenus ayant une signification proche se retrouvent alors proches dans l'espace vectoriel. Cette proximité est généralement mesurée à l'aide de la similarité cosinus. 2. Des recherches plus rapides à grande échelle Les bases vectorielles utilisent des algorithmes d'indexation spécialisés pour retrouver rapidement les vecteurs les plus proches, même parmi plusieurs millions de documents. Cette capacité est essentielle dans un système RAG où les informations pertinentes doivent être récupérées en temps réel. Le pipeline de transformation Étape 1 : Chunking Les documents sont découpés en morceaux appelés chunks. Ce découpage peut être fixe (fixed-size), basé sur la structure du texte (semantic chunking) ou avec chevauchement (sliding window). Étape 2 : Embedding Chaque chunk est converti en vecteur numérique par un modèle d'embedding. Ce vecteur capture le sens du contenu et permet de le comparer à d'autres textes. Étape 3 : Stockage vectoriel Les vecteurs sont stockés dans une base vectorielle telle que Pgvector, Pinecone, Weaviate, Milvus ou Qdrant. Lorsqu'un utilisateur effectue une requête, celle-ci est également transformée en vecteur. Le système recherche alors les chunks les plus proches sémantiquement et les transmet au modèle de génération afin de produire une réponse contextualisée.

On parle souvent de Clean Code, d'architecture ou de frameworks… mais beaucoup de développeurs utilisent des design patterns tous les jours sans même s'en rendre compte.
Article
07 Jul 2026 • Lecture 5 min

On parle souvent de Clean Code, d'architecture ou de frameworks… mais beaucoup de développeurs utilisent des design patterns tous les jours sans même s'en rendre compte.

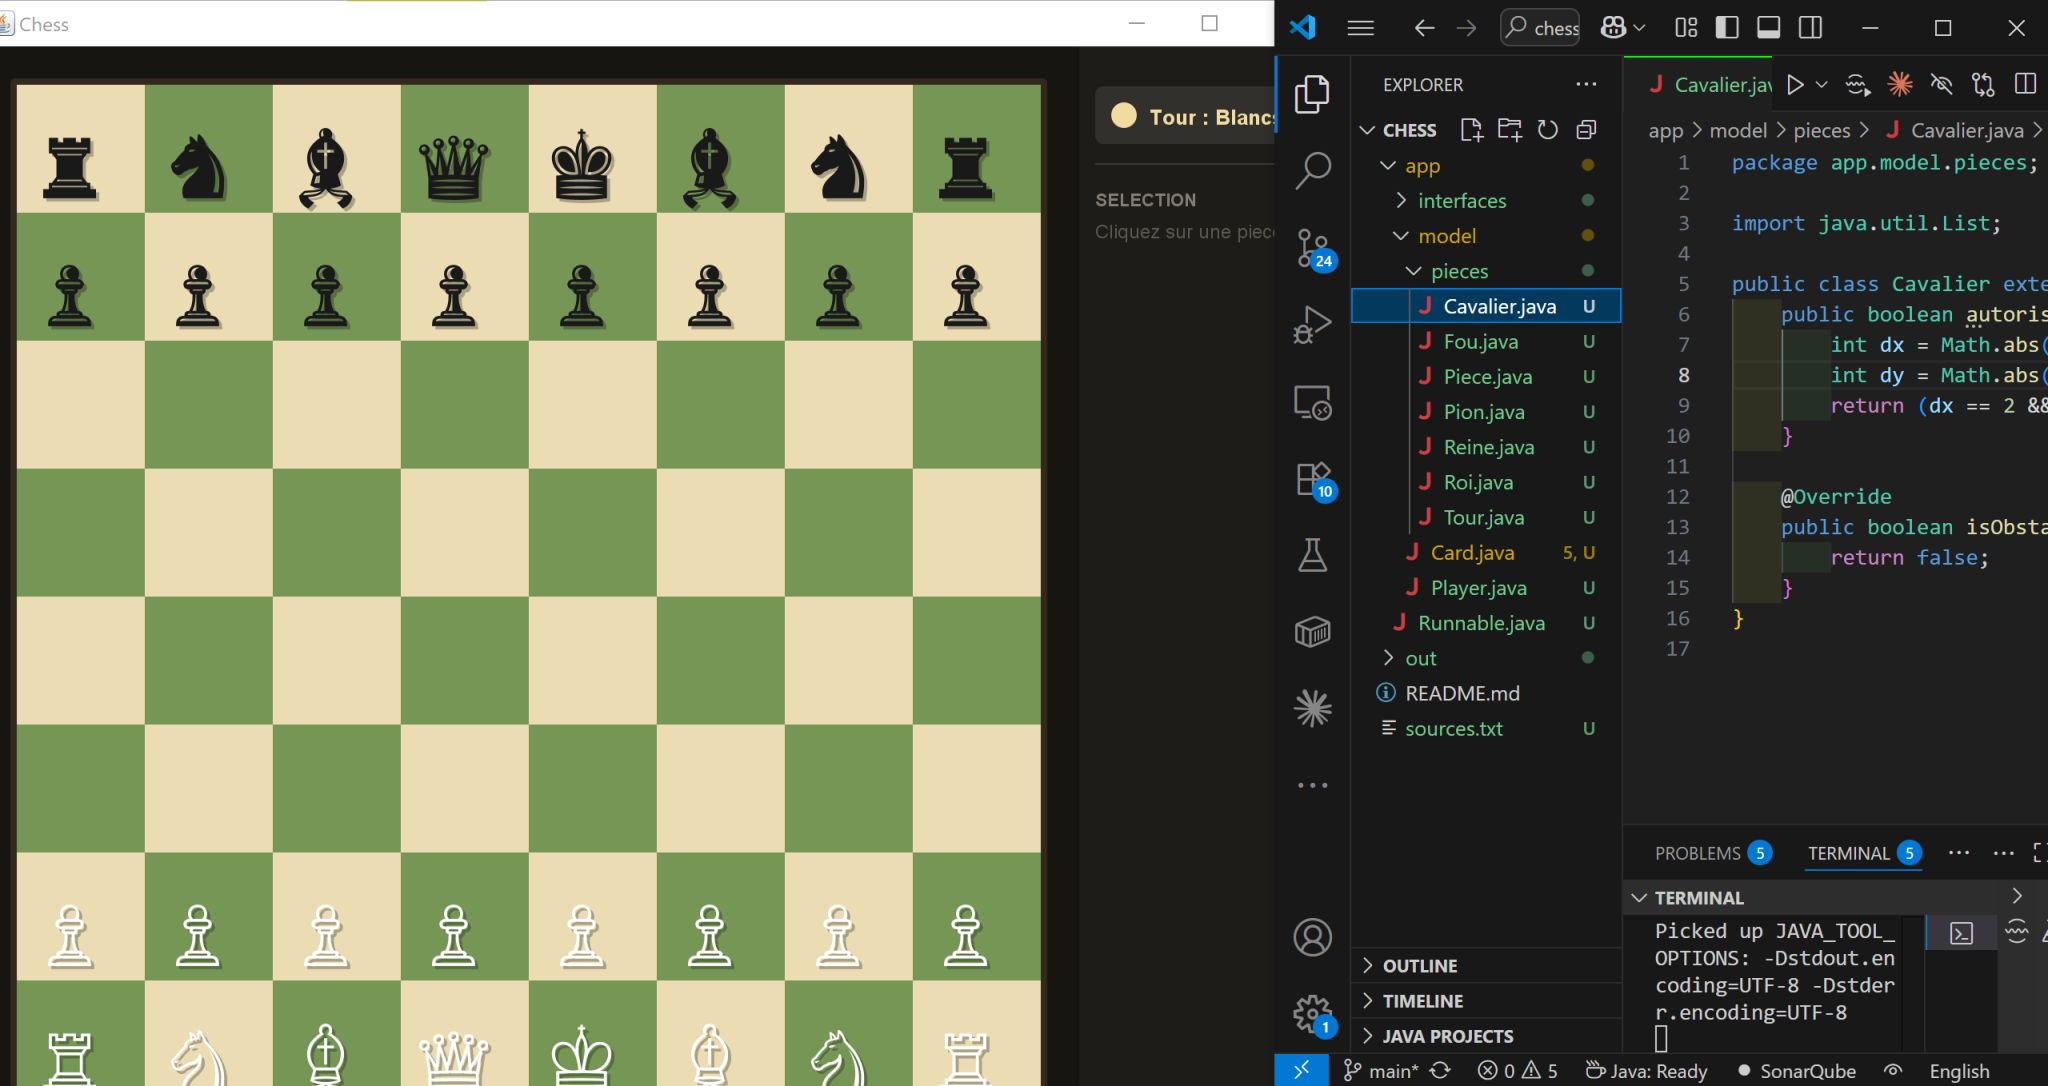
Spring, Angular, Laravel ou Symfony implémentent de nombreux design patterns sous le capot. Les design patterns du Gang of Four (GoF) sont regroupés en trois grandes familles : 🏗️ Creational : ils définissent la manière de créer les objets. On y retrouve notamment Factory, Builder et Singleton. 🔗 Structural : ils organisent la façon dont les objets et les classes s'assemblent. Des exemples connus : Adapter, Decorator et Composite. 🔄 Behavioral : ils gèrent les interactions entre les objets et la répartition des responsabilités. Parmi eux : Observer, Strategy et Command. Pendant longtemps, je les trouvais très théoriques. Puis je me suis lancé un défi : développer un jeu d'échecs en Java, sans framework, à partir de zéro. En pratique, chaque problème de conception rencontré m'a naturellement conduit vers un design pattern. Chaque pattern n'était plus une définition apprise dans un livre, mais une réponse naturelle à un problème concret de conception. Les frameworks nous rendent très productifs, mais ils masquent souvent les décisions d'architecture qui se cachent derrière. Comprendre les design patterns, ce n'est pas seulement écrire du code plus propre. C'est apprendre à concevoir des logiciels lisibles, évolutifs et faciles à maintenir. Et toi, quel est le premier design pattern que tu as utilisé… avant même de savoir qu'il portait un nom ? 👇

🔧 Kotlin Multiplatform en production : ce que ça change vraiment
Article
14 Jul 2026 • Lecture 5 min

🔧 Kotlin Multiplatform en production : ce que ça change vraiment

Sur un projet mobile récent, j’ai fait un choix assez clair : plutôt que de maintenir deux codebases natives, partir sur Kotlin Multiplatform + Compose Multiplatform. L’application est une plateforme de transactions sécurisées entre acheteurs et vendeurs, destinée à un marché arabophone. Au final : 52+ routes de navigation 30+ ViewModels 3 langues : FR / EN / AR Android (API 26+) et iOS 16+ Kotlin 2.0 Et surtout, une grande partie du code vit dans commonMain. 📱 Ce que ça change au quotidien La logique métier n’est plus dupliquée entre Android et iOS. Par exemple, tout le cycle d’une transaction — génération du code, paiement, livraison, gestion d’un éventuel litige — est développé une seule fois. Cela évite une bonne partie des problèmes du type : « ça fonctionne sur Android, mais pas sur iOS ». Côté architecture, nous sommes partis sur MVVM + StateFlow, avec un UiState immutable exposé par chaque ViewModel. L’état est ainsi centralisé, observable et facilement testable. 🌍 Et pour le multilingue ? FR, EN et AR sont gérés directement dans le code partagé, avec le support du RTL. Avec moko-resources, les ressources sont typées et générées à la compilation, tout en restant accessibles depuis les deux plateformes. ⚠️ Le vrai piège de KMP Ce n’est pas forcément la technologie. C’est de vouloir tout partager à tout prix. Dans ce projet, les quelques implémentations spécifiques aux plateformes concernent principalement : les notifications push ; la gestion des permissions ; certaines parties du réseau selon la plateforme. Pour le reste — UI Compose, ViewModels, appels API avec Ktor/Ktorfit, sérialisation, navigation — le code est partagé dans commonMain. Et honnêtement, c’est là que KMP prend tout son sens. 🛠️ Une difficulté que je n’avais pas anticipée Le build iOS en CI/CD était assez lent. Après optimisation de la configuration Kotlin/Native et la désactivation de certaines phases d’analyse, notamment autour de la dévirtualisation et de l’escape analysis, nous avons obtenu une amélioration sensible des temps de build. Comme souvent, il s’agit d’un compromis : gagner du temps côté build au prix de quelques optimisations runtime. Au final, mon retour sur KMP est plutôt positif. Mais je pense que sa vraie valeur n’est pas simplement de dire « un seul code pour deux plateformes ». C’est surtout de pouvoir partager la logique métier et l’architecture, tout en gardant la liberté de laisser aux plateformes ce qui doit réellement leur appartenir. Vous avez déjà mis KMP en production ? Quel a été votre plus gros point de friction ?

🕵️ Dette technique : le vrai visage du métier de développeur
Article
21 Jul 2026 • Lecture 5 min

🕵️ Dette technique : le vrai visage du métier de développeur

On parle beaucoup du greenfield : partir d’une page blanche, choisir sa stack, définir une architecture propre et construire quelque chose de zéro. Mais dans la réalité, une bonne partie du travail consiste plutôt à reprendre ce qui existe déjà. Un projet sans documentation. Des choix techniques faits il y a plusieurs années. Des dépendances obsolètes. Une base de données qu’on ne peut pas simplement modifier sans risquer de casser des migrations ou des fonctionnalités existantes. Et c’est là que la dette technique devient vraiment intéressante. Avec le temps, j’ai pris quelques réflexes quand je reprends une base de code existante : 🔍 Comprendre avant de remplacer Avant de supprimer un composant déprécié, je cherche à comprendre où et comment il est utilisé. Le remplacer proprement ne doit pas créer trois nouveaux problèmes ailleurs. 📛 Tout n’a pas besoin d’être refait Parfois, on tombe sur un choix historique qu’on ferait différemment aujourd’hui. Mais si le changement implique de toucher à trop de choses, le conserver peut être la décision la plus pragmatique. 📝 Documenter ce qu’on découvre Quand on comprend enfin pourquoi une partie du système fonctionne d’une certaine manière, cette information ne devrait pas rester uniquement dans notre tête. Parce que finalement, savoir développer ne signifie pas seulement savoir écrire du nouveau code. Savoir lire du code qu’on n’a pas écrit, comprendre sa logique implicite et intervenir sans casser l’existant est une vraie compétence d’ingénierie logicielle. Et parfois, le meilleur développeur n’est pas celui qui réécrit tout. C’est celui qui sait quoi changer, quoi conserver et pourquoi. Et vous, quelle est votre approche quand vous arrivez sur une base de code legacy sans documentation ?

Restez informé

Abonnez-vous à notre newsletter pour recevoir nos derniers articles directement dans votre boîte mail.

Chatbot

Chatbot

Always ready to help!
Chatbot
Bienvenue chez Databoost. Notre équipe est à votre disposition pour vous accompagner. Comment pouvons-nous vous aider aujourd’hui ?
Chatbot